FINDING 01
1. 更好的位姿不会机械地带来更好的原生深度
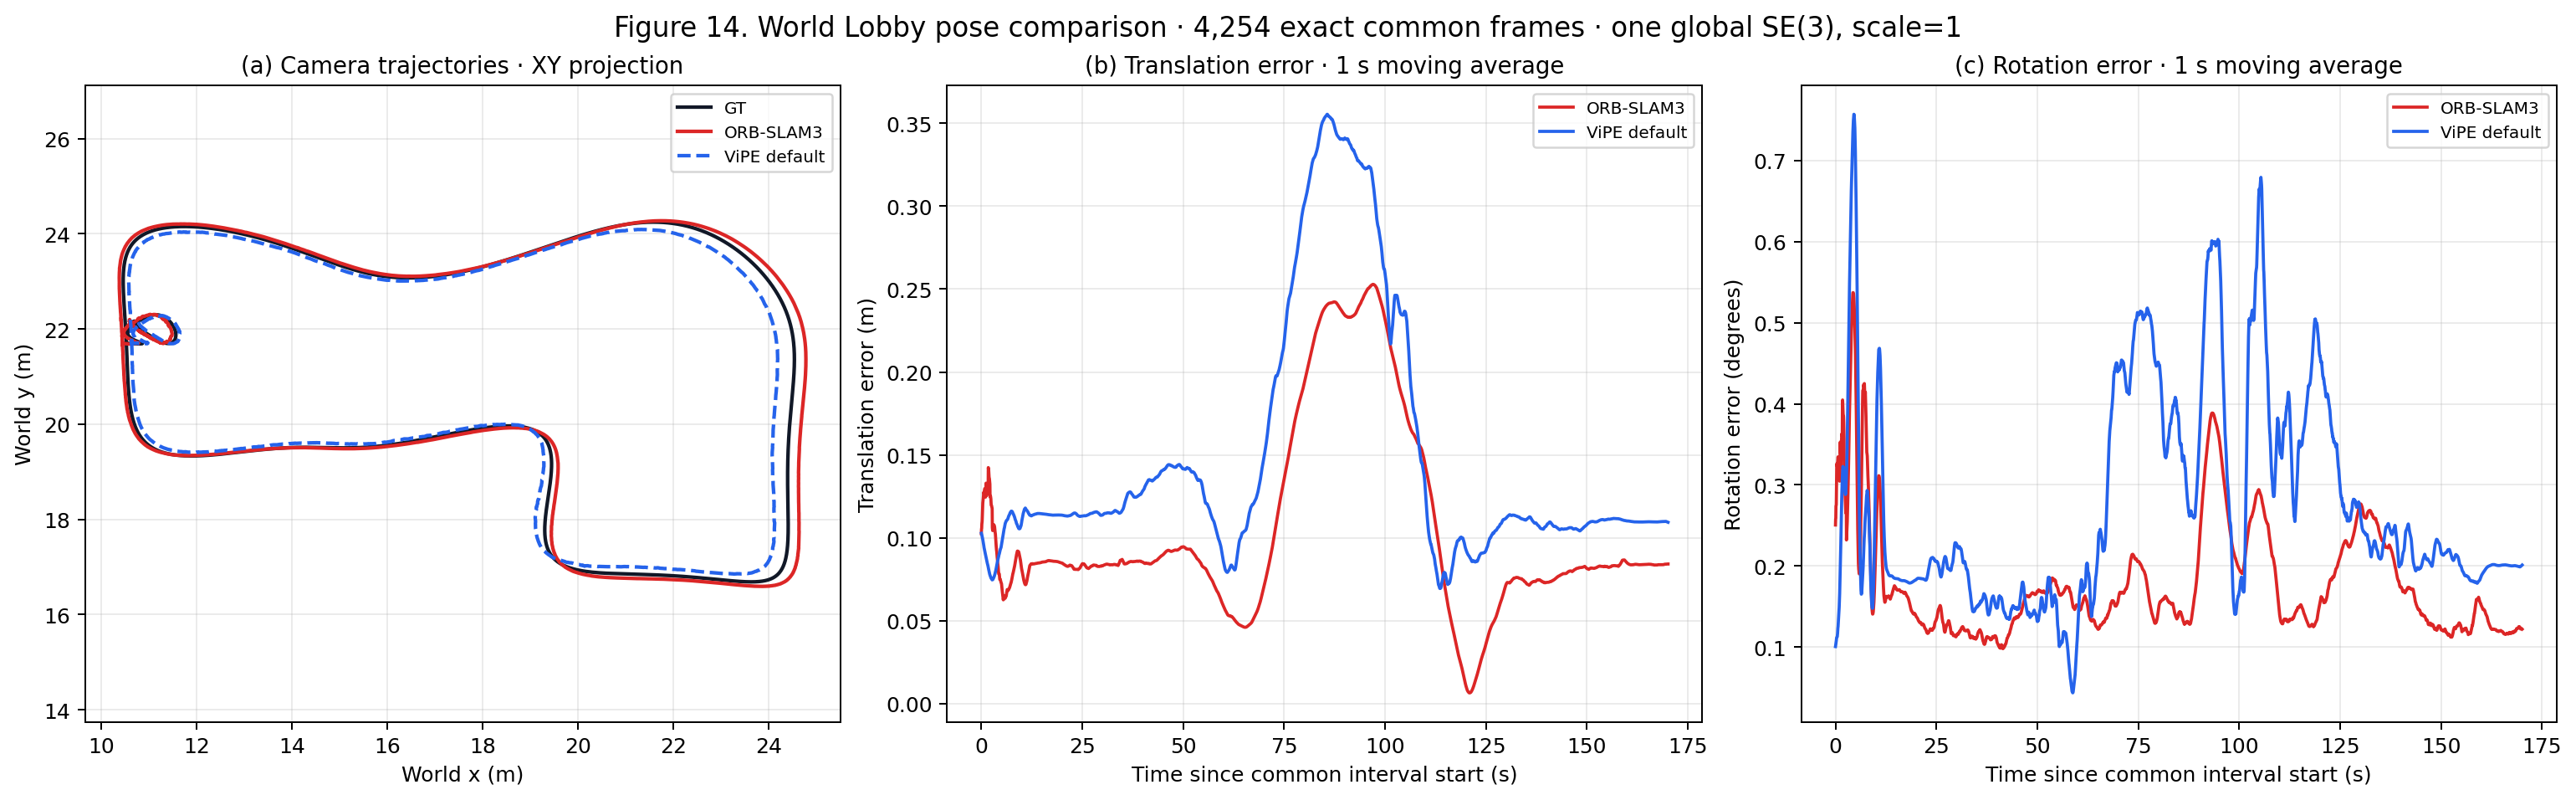
M3 的轨迹优于 M2:ATE 从 0.167 m 降至 0.121 m,旋转误差从 0.31° 降至 0.19°;但 M3 的原生 DA3 AbsRel 反而略差(20.38% 对 19.06%)。经过建模后,排序再次反转:M3 的模型深度 AbsRel 为 8.37%,优于 M2 的 9.29%。上游指标与最终场景忠实度相关,却不能彼此替代。
RESEARCH ESSAY · EDITABLE WORLD MODELS
同一场景、四条重建路径:位姿、深度与程序化建模如何共同塑造一个可编辑三维世界。
01 / RESULTS
图像生成奖励一张令人信服的画面;空间系统承担更严格的义务:当相机移动时,尺度、位置、遮挡与物体边界仍需保持一致,而且渲染结束后,结果还必须能够被编辑。
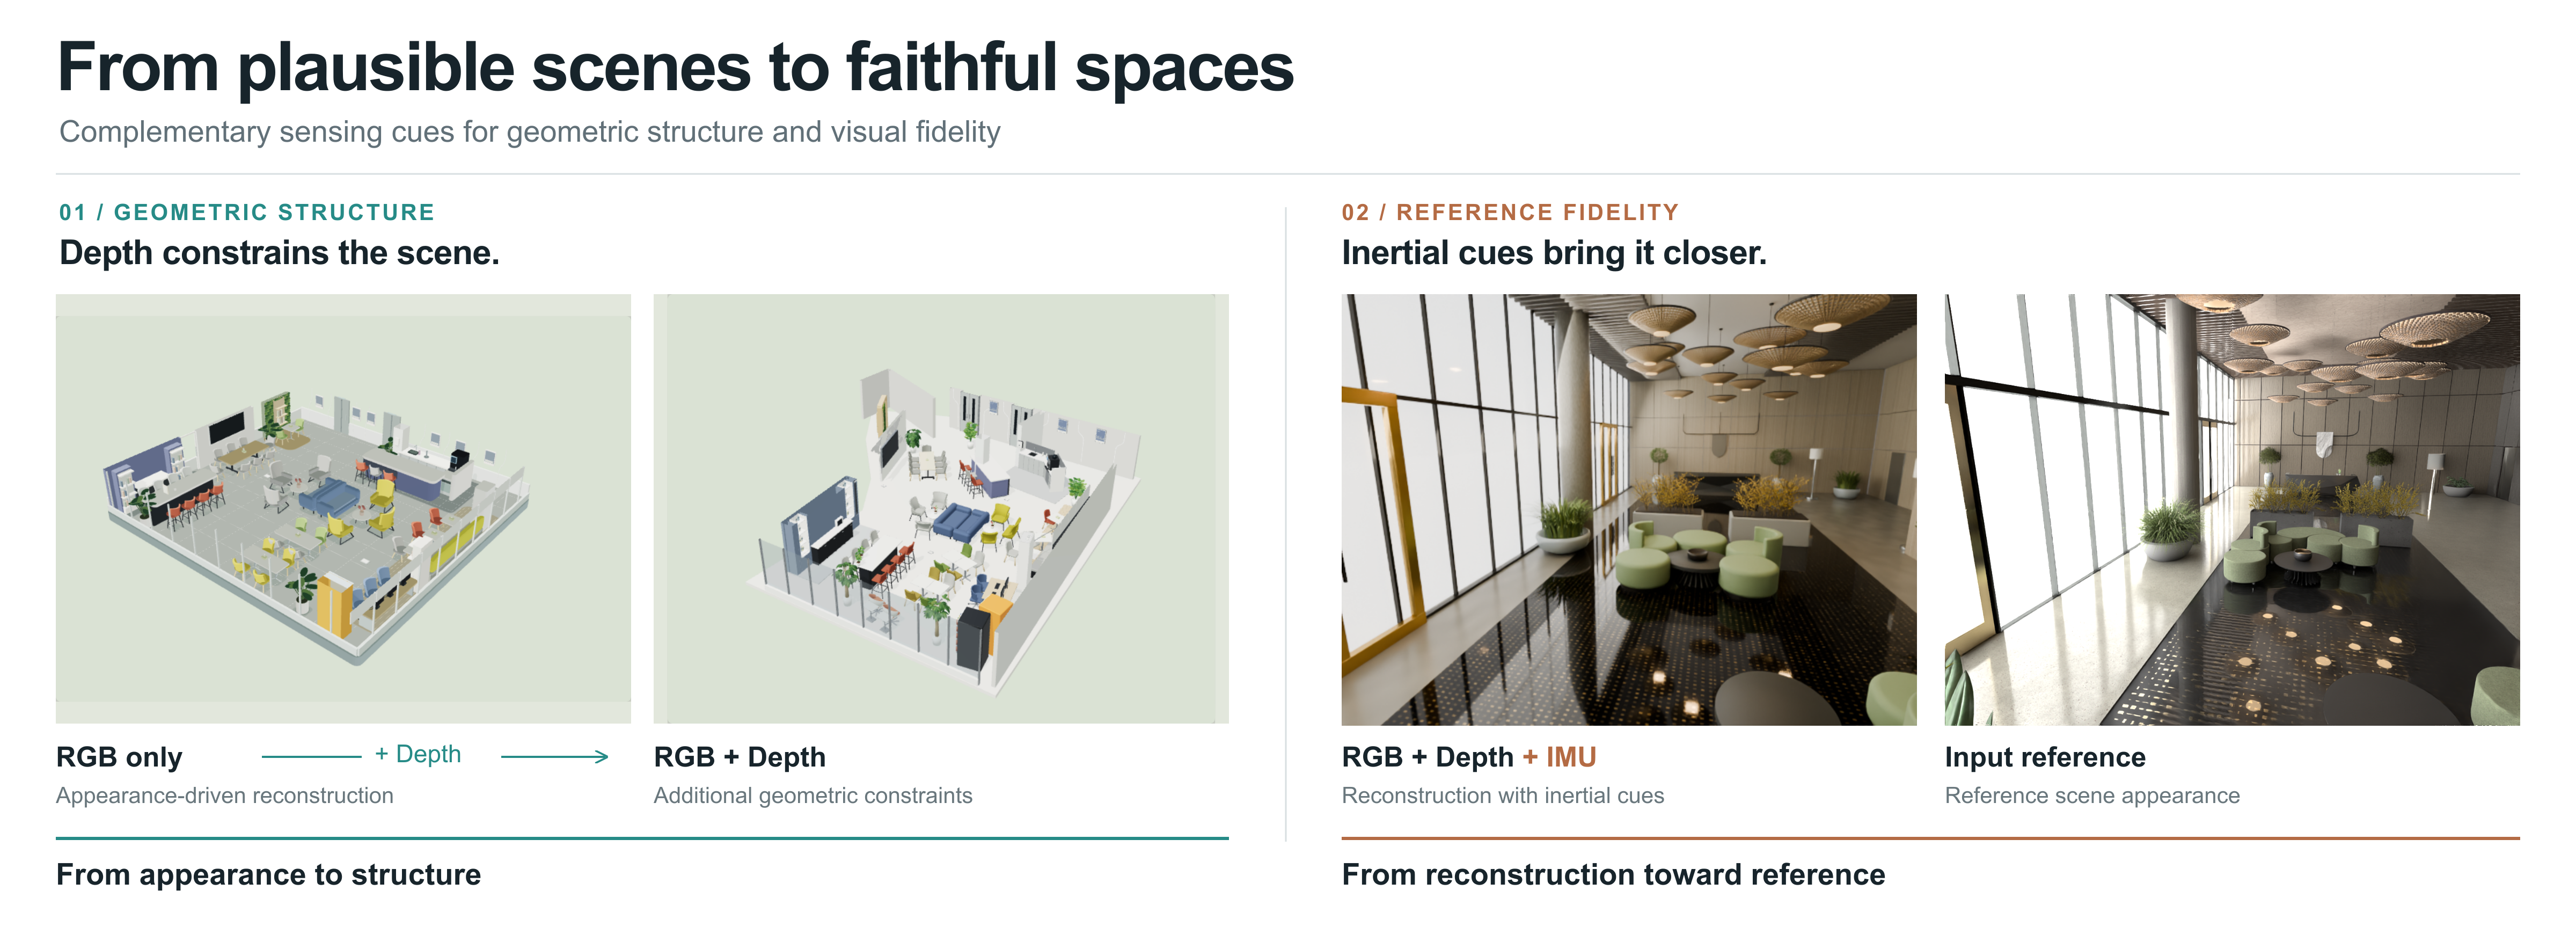
我们让同一个 World Lobby 沿四条完整工程路径重建:从纯 RGB 建模,逐步加入估计位姿、深度与真实相机位姿。每条路径交付的是冻结的 Blender 场景,而不只是点云或新视角渲染器。实验关注的不是谁生成了最漂亮的单帧,而是几何证据究竟带来了什么、没有解决什么,以及哪些误差会穿过对象化建模继续存在。
M1 数值使用诊断性的 GT-assisted Sim(3);所有结论仅适用于本次冻结的单场景研究。
02 / MOTIVATION
可编辑世界模型的价值,在于其中的对象能够被选择、移动、隐藏、赋予材质、查询碰撞,并从已知相机重新访问。这些能力服务于设计、机器人与仿真,也会暴露一张漂亮图片可以掩盖的空间错误。
我们的工作假设是:测量不是生成推理的替代品,而是它的约束。位姿与深度应当缩小合理布局的解空间,建模系统则把噪声观测压缩为语义场景。这种转换可能正则化噪声,但同样是有损的:遗漏的表面、近似的材质,不会仅仅因为相机轨迹更准确而自动恢复。
03 / WORKFLOW
四条路径使用相同的 180 张 RGB 身份和相同的 Astra–Blender 建模目标。M1 检验没有米制测量时视觉先验能走多远;M2 加入 RGB-only ViPE 位姿与 pose-conditioned DA3 深度;M3 使用 ORB-SLAM3 单目惯性位姿与同类 DA3 观测;M4 提供 GT 相机位姿,用于诊断剩余建模误差,但建模时不读取 GT 网格或 GT 深度。
所有场景冻结后才引入真值。M2/M3 只使用一次全局 SE(3) 配准,尺度固定为 1;不进行 mesh ICP 或逐视角拟合。M1 没有原生米制轨迹,其模型空间指标使用由 5 个手工相机关联得到、冻结不变的 GT-assisted Sim(3),因此只能解释形状与显示误差,不能视为米制恢复。
04 / MORE RESULTS AND ANALYSIS
FINDING 01
M3 的轨迹优于 M2:ATE 从 0.167 m 降至 0.121 m,旋转误差从 0.31° 降至 0.19°;但 M3 的原生 DA3 AbsRel 反而略差(20.38% 对 19.06%)。经过建模后,排序再次反转:M3 的模型深度 AbsRel 为 8.37%,优于 M2 的 9.29%。上游指标与最终场景忠实度相关,却不能彼此替代。
FINDING 02
在声明配准且不使用 mesh ICP 的条件下,双向表面误差从纯 RGB 诊断基线的 0.376 m,依次降至 ViPE 的 0.118 m、ORB-SLAM3 的 0.082 m 与 GT 位姿的 0.072 m。M4 在本案例中拥有最强几何,而 M3 依靠估计轨迹已经缩小了大部分差距。
FINDING 03
外观指标没有统一冠军。在 100 视角检查中,M2 的 PSNR 最高(13.21 dB),M3 的 SSIM 最高(0.397),M4 的 LPIPS 最低(0.524);与此同时,M4 的几何与模型深度最好。更忠实的空间仍可能因为近似材质、光照与简化物体边界而损失像素相似度。
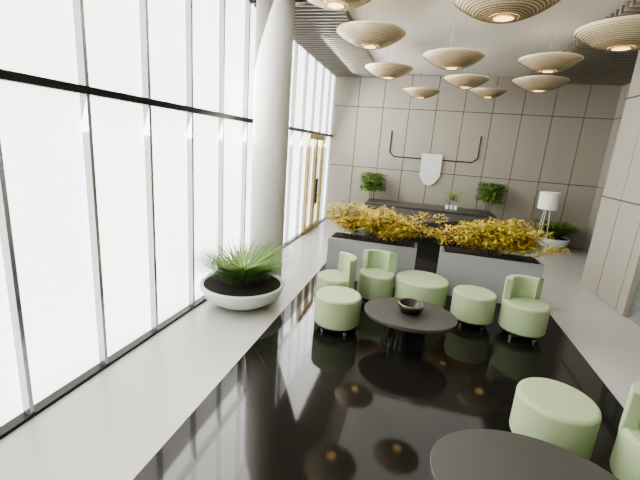
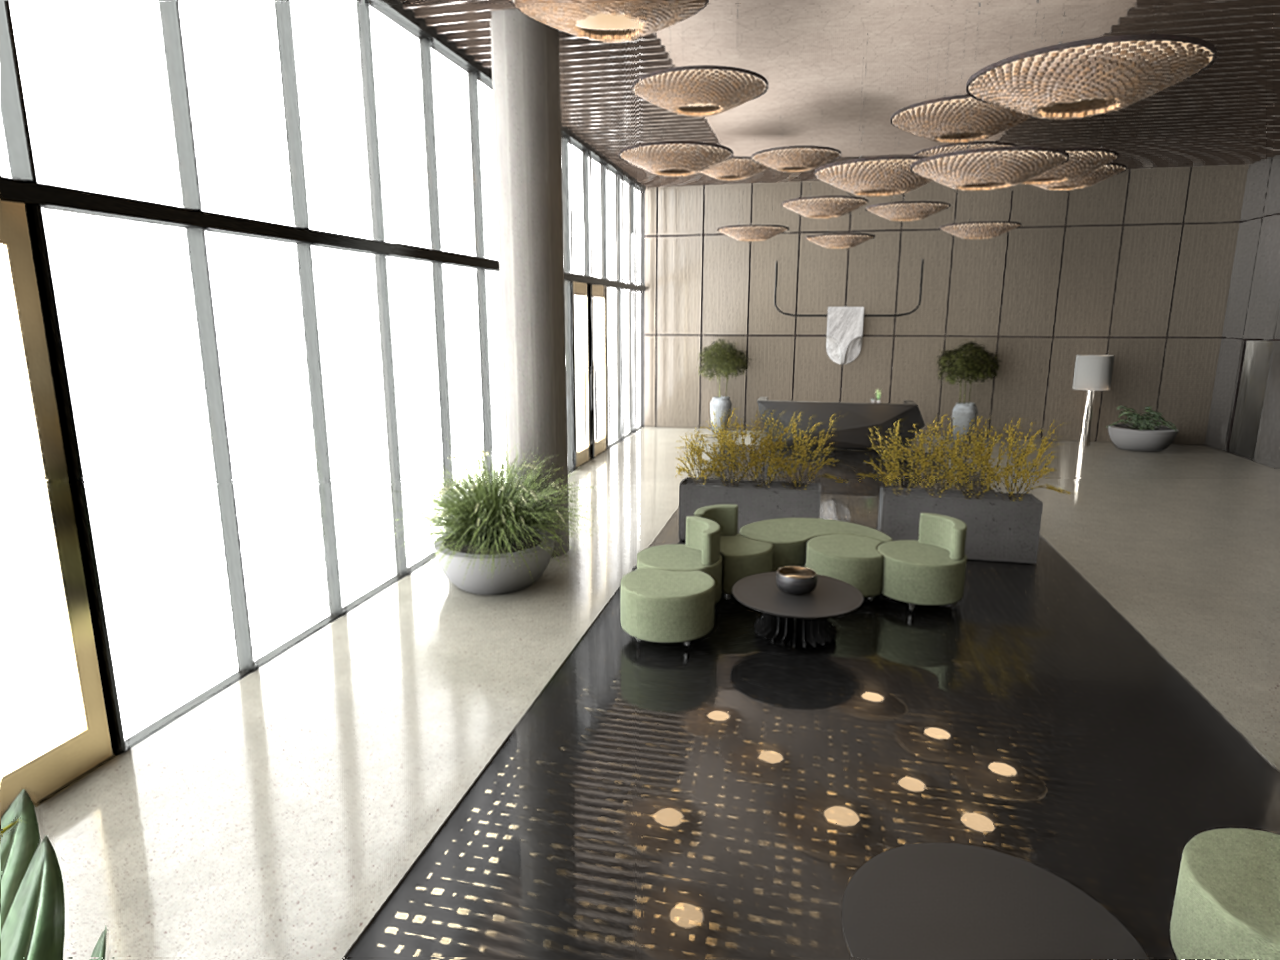
在共享相机中将每个重建与 GT 对照:先从 M1 观察语义上合理的房间如何偏离米制布局;再比较 M2/M3,寻找几何改善但 RGB 相似度未同步提升的区域;最后检查 M4,把相机位姿不再是瓶颈后仍然存在的建模与材质误差分离出来。
滚动到此处加载三维对比。
M1 / 视角 0
INPUT / GT RGB
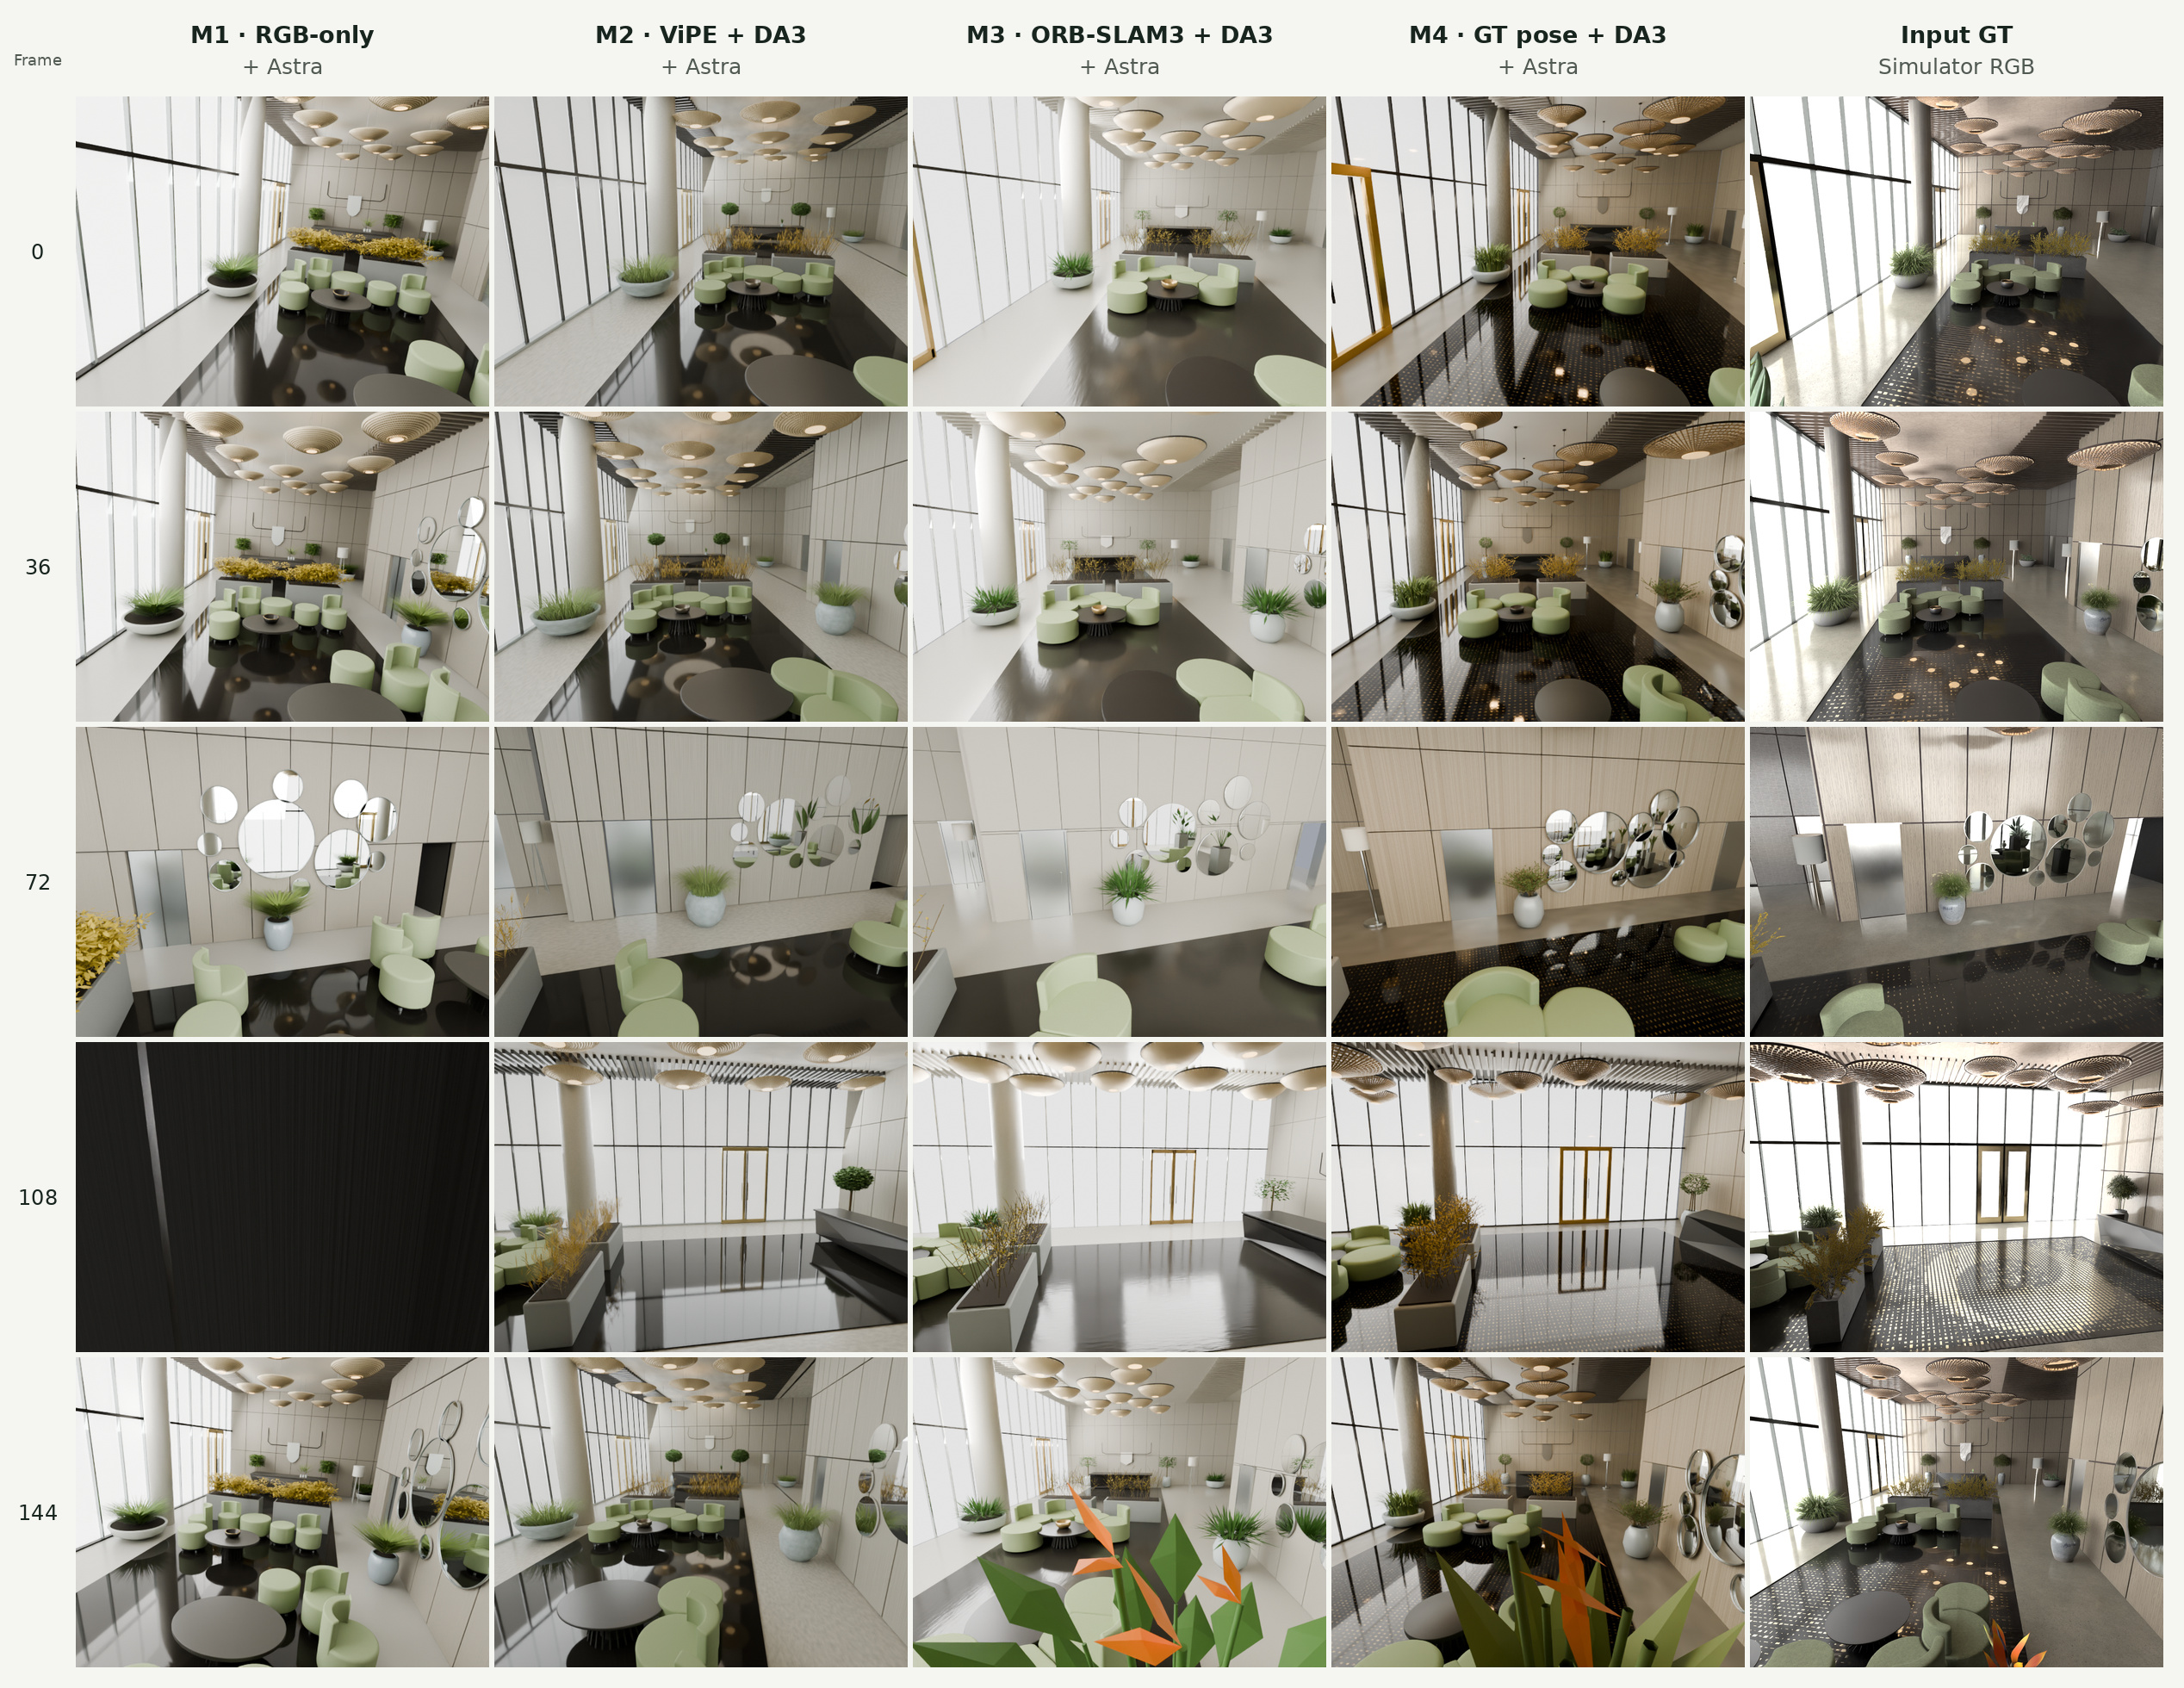
网页只在运行时隐藏顶棚与四周墙体,以便剖视检查;运行时配准与显示选择不会修改可下载的冻结 GLB 或 Blend 文件。
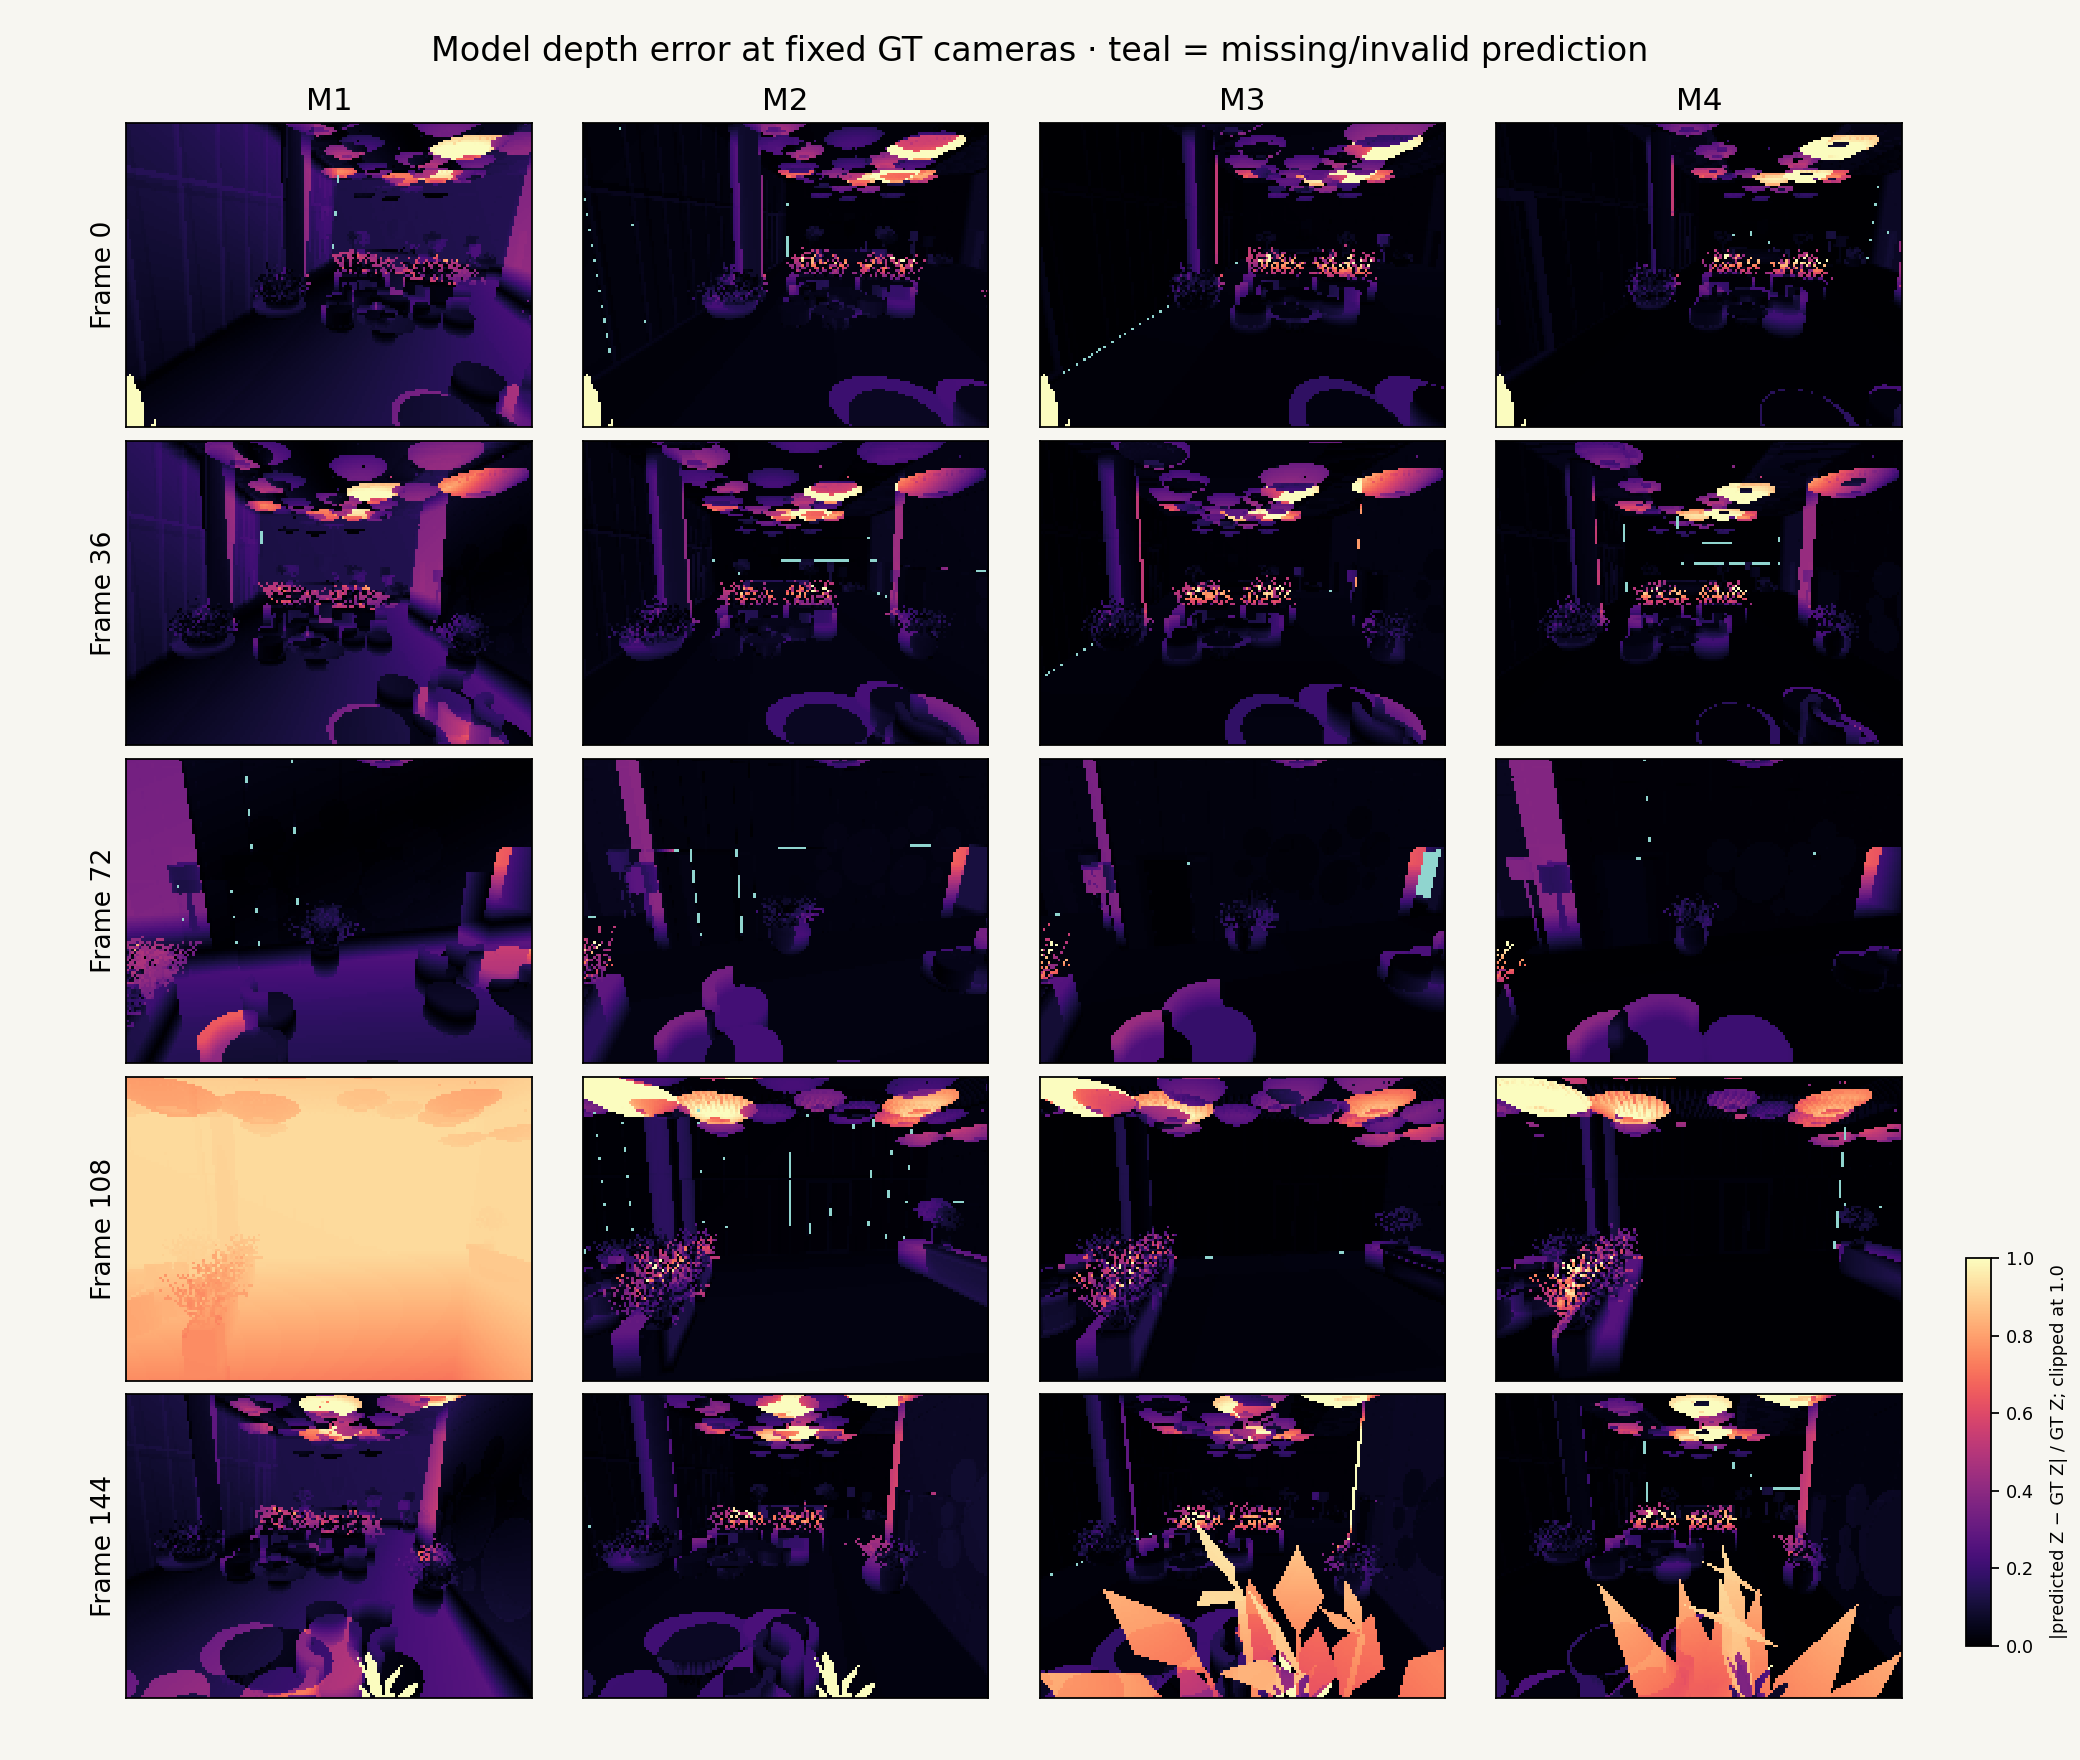
在共享的 180 视角协议下,M2–M4 的最终场景深度都显著接近 GT:相较原生 DA3,AbsRel 约下降 51–60%。一种可能解释是,对象级聚合抑制了局部不一致预测;但这仍是假说,而非受控因果结论。同一种抽象也可能删除真实表面与细节。
几何最强的路径并未统治 PSNR 或 SSIM。位姿消除了一类不确定性,外观仍受材质估计、照明、物体细节与渲染器差异支配。只评 RGB 会漏掉空间进步,只评几何也会漏掉感知失败。
Table 5/7 使用同一组固定随机种子的 100 个相机,它们从固定 5 帧之外的 175 张建模帧中抽取。这些视角相对固定检查是额外视角,但其 RGB 在建模阶段可见。在该集合上,M4 的深度 AbsRel 最低(7.47%),M3 的 RMSE 最低(1.090 m)。
06 / LIMITATIONS
所有表格都由冻结资产生成;公开 manifest 提供模型哈希、配准、固定视角与固定随机评测索引。
M1 scene.blend ↓ · scene.glb ↓ · manifest ↗
M2 scene.blend ↓ · scene.glb ↓ · manifest ↗
M3 scene.blend ↓ · scene.glb ↓ · manifest ↗
M4 scene.blend ↓ · scene.glb ↓ · manifest ↗
Tables JSON · Scene manifest · Fixed views · Publication manifest · SHA256
07 / CITATION
如果本研究的受控实验、冻结资产或评测协议对你的工作有帮助,请引用下面的交互式研究文章。
@misc{agentic_world_2026,
  title        = {Plausible Is Not Faithful: Pose, Depth, and Agentic Blender Reconstruction},
  author       = {Agentic World Contributors},
  year         = {2026},
  howpublished = {\url{https://wentingw.github.io/agentic-world-blog/}},
  note         = {Interactive research article and frozen evaluation assets}
}
08 / REFERENCES